
在动手开发之前,先验证你的创业点子
看清这个点子值不值得继续——以及哪件事最值得关注——别再花几个月做一个错误的产品。
约 5 分钟 · 诊断预览免费 · 执行套件一次性 $2.99
- 结论与 7 个维度分数——免费,无需注册
- 执行套件(7 天计划、MVP、实验)——一次性 $2.99
- 规则引擎打分——相同输入,必出相同报告
关键假设
“这个产品要跑通,关键在于运营者能直接接触外语家教群体。”
第 1 天 · 第一份证据
写出你现在没有的那一项具体技能或人脉,如果没拿到它,这个项目就完蛋;再写一句什么证据能补上。
第 7 天 · 证据会决定什么
继续 / 调整 / 重测 / 停止——下周证据对应的标签,不是「这个点子会成功」的预测。
- 继续
- 调整
- 重测
- 停止
总分
置信度 78%·阶段 · MVP
要点速览: Yibud 的作用,用通俗的话讲
- Yibud 把一句话的想法变成决策判定与 7 维度评分——免费,无需注册。
- 每个分数都来自确定性规则引擎,而不是语言模型——同样的输入永远输出同样的报告。
- 可选的 AI 层只润色文字;它从不决定数字、结论或建议。
- 免费报告会指明一个最关键的假设,并给出分数信号。可执行的 7 天验证行动计划和 4 周首批客户计划属于一次性 $2.99 的执行套件。
- 想先学这套方法论的创始人,可以看 Startup Validation 中心里的六步学习路径。
不是 AI 头脑风暴工具,而是 结构化创业决策引擎。
- 结构化评分
- 先验证后构建
- 创始人证据
- AI 辅助
你将获得什么
不是一个分数,而是一份创业决策报告。
关键假设
“这个产品要跑通,关键在于运营者能直接接触外语家教群体。”
第 1 天 · 第一份证据
写出你现在没有的那一项具体技能或人脉,如果没拿到它,这个项目就完蛋;再写一句什么证据能补上。
第 7 天 · 证据会决定什么
继续 / 调整 / 重测 / 停止——下周证据对应的标签,不是「这个点子会成功」的预测。
- 继续
- 调整
- 重测
- 停止
总分
72/ 100大多数创始人在验证之前就动手开发
六个月开发,三个付费用户,然后发现没人真的需要它。Yibud 的目标不是预测成功,而是帮助你尽早发现错误。
过早开发
花几个月开发一个还没经过真实用户验证的东西。
没有真正可执行的获客策略
没有可重复、低成本触达前 100 个客户的渠道。
没人真的付费
兴趣存在,但没付费意愿。痛点真实,预算不存在。
三步得到一份结构化决策。
每个想法都跑过同一套确定性框架——没有黑箱。分数来自公开透明的规则,AI 用大白话解释含义和下一步动作。我们不预测成功,只告诉你你的点子最依赖哪一个假设——决定权在你手上。
描述你的点子
一句话就够。描述得越清晰,分析就越到位。
回答 5 个简短问题
受众、变现模式、获客渠道、技术背景,以及你已经看到的风险。
阅读你的决策报告
一个 0–100 的总分、各维度细分、3 个最关键风险、一份 MVP 蓝图,以及一份本周一就能开干的首客计划。
分数只是起点,不是终点
每份 Startup MRI 报告会指明一个最高风险的假设,并把它转化为一组 7 天验证行动计划——一天一个动作、一段证据目标,到第 7 天给出明确的「继续 / 优化 / 复测 / 停止」信号。
生成你的计划
获得一份 7 天验证行动计划
用一句话描述你的想法,再回答 5 个简短问题。报告会附带一份结构化的验证周表——每天都有动作、目的、要收集的证据。
分析你的想法 →查看完整示例
在 SaaS 示例报告里读一份成品
SaaS 示例报告在「关键假设」下方展示了完整的 7 天行动计划——你的报告会包含同样的部分。
打开 SaaS 示例 →
7 天验证行动计划是决策辅助——不是对创业成功的预测。决定权属于你。
关于 Yibud
每个创始人都有无数个点子。大多数失败,是因为验证发生得太晚 —— 在花了几个月做错事之后。
Yibud 的存在,是为了帮助创始人在动手开发之前先验证那些真正重要的假设。它不会预测你会成功,只会帮你降低犯错的代价。
布丁
Yibud 的灵感来自一只蓝眼睛斯芬克斯猫,名叫布丁。好奇、冷静、善于观察。创业验证本该如此。
常见问题
Startup MRI 是怎么工作的?
大多数创业点子不是死在写代码上,而是死在花了几个月开发之后,才发现需求没验证过。Startup MRI 存在的意义,就是帮你在投入几周或几个月之前,先识别出最大的风险。 你填 5 个字段:问题、目标受众、变现模式、获客渠道、技术背景。一个确定性的规则引擎会跑 34 条加权检查,覆盖 7 个维度:验证可行性、分发渠道、市场需求、变现模式、竞争格局、创始人匹配度、构建难度。这七项再合成机会分与总体创业分。完整报告在 60 秒内生成。 默认情况下,报告里的每一句话都来自规则引擎。当配置了大模型时,会有一个可选的第二步润色文字——但不会改数字,也不会改建议。正是这一层确定性,让两个相同的输入产生相同的报告:你下周重新跑同一个点子,可以验证分析结果是可复现的。
Startup MRI 能预测创业成功吗?
不能,而且它也不打算。三件事让创业结果在原则上不可预测:市场时机变化、团队执行差异、外部冲击。任何声称能预测它们的工具,卖的都是感觉,不是预测。 Startup MRI 评分的是你能真正控制的输入——问题的清晰度、获客渠道的强度、变现模型的合理性、你的背景与点子所需能力之间的差距。它是用来降低不确定性的,不是消除不确定性。高分代表你的输入与成功独立产品观察到的模式一致,低分则代表不一致。无论哪种,决策——以及结果——都是你的。
Startup MRI 和 ChatGPT 有什么区别?
三件事。 第一,数字是确定性的。明天提交同样的输入,得到的分数完全一样——逐字节相同。这种一致性让对比和迭代更容易:当你改了一个输入重新跑,你能确切知道哪个分数动了、为什么动了。问 ChatGPT 两次通常会得到不同答案,而且倾向于更积极,因为大语言模型训练的目标就是有帮助、令人鼓舞。 第二,每个数字都能追溯到一条具体规则,这条规则因为某个具体输入而被触发。如果某个分数感觉不对,你几乎总能指出是哪个输入触发了哪条规则。 第三,报告里包含一份由同一规则引擎生成的 4 周首批客户计划。ChatGPT 给你的是通用 30 天计划;Startup MRI 的计划反映你选的渠道、受众和变现方式。 Startup MRI 里的 AI 只负责润色文字。分析本身来自规则引擎。
报告有多准确?
准确度取决于输入质量。一个模糊的点子加上随便选的答案,产出的报告会带着这种模糊——分数反映的就是你描述的模糊程度。报告不会比你描述的更懂你的点子。 规则引擎是有意为之的「有立场」。34 条检查中的每一条都编码了一个模式,这些模式来自「资料来源」页列出的客户开发与精益创业文献:薄弱的获客、未经验证的定价、创始人技能不匹配、范围过大的 MVP。分数表达的是你的输入对这些模式回答得多清楚,它不是对增长的预测。 把分数当起点,不是判决。7 个子分和「证据」一节才是真正有用的信号所在。
Startup MRI 是免费的吗?
分析一个想法是免费的,也不需要注册账号。 免费部分:决策判定(推进 / 谨慎 / 暂缓)、总评分,以及全部 7 个维度分数。这正是判断这个想法值不值得继续投入时间的那部分。 一次性 $2.99:解锁这份报告的执行套件——今天就能执行的最小市场验证、7 天计划、推荐实验、MVP 蓝图与创始人指南。没有订阅,不会重复扣费。 我们收的是可执行方案的钱,不是决策信号的钱。示例报告始终可以免费完整阅读,付费前你就能看清这 $2.99 究竟解锁了什么。
我应该如何使用评估结果?
三步,按顺序来。 第一步,读「最关键假设」一节。引擎会挑出唯一那条假设——如果它是错的,后面所有规划都会失效。如果你在动手前能找到证据,去找;如果找不到,报告剩下的部分都是次要的,直到你找到为止。最关键假设和 7 个维度分数就是免费的决策信号。 第二步,解锁一次性 $2.99 的执行套件后,把 4 周首批客户计划当清单来执行。这份可执行计划在付费套件里——由你的输入生成,具体到「30 天内把点子放到潜在客户面前」该做什么动作。把它当成真正的项目,不是「之后再说」的事。 第三步,第一次读完之后就忽略总分。它是摘要数字,不是目标。如果三个子分都偏低,你有三件具体的事要做——不是模糊地「这事儿风险大」。 动手写代码前做完这三步,一个月内你就能知道这个点子值不值得接下来六个月。跳过它们,报告就是抛硬币。
我们写的关于创业验证的一切
文章、验证指南、FAQ 和词汇表 —— 所有资源集中在一处。选择与你当前阶段匹配的那个。
验证、渠道与创始人的经验
来自 Startup MRI 团队的短篇观点文章 —— 谈那些没人愿意老实讲的创业真相。
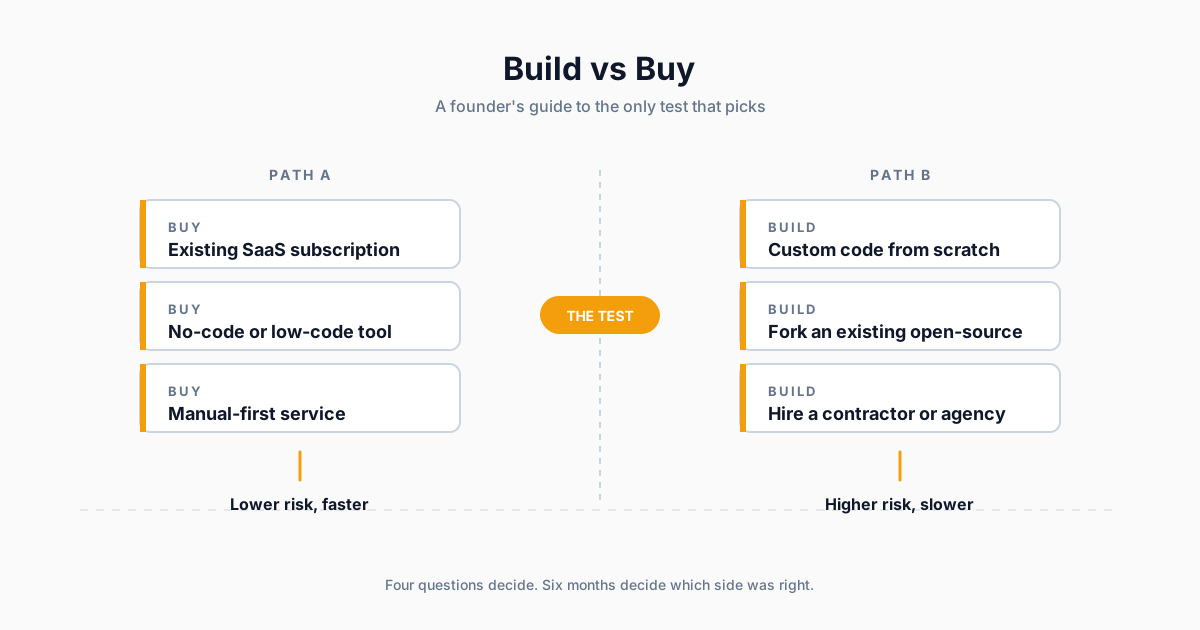
Founder Mindset
The Build-vs-Buy Decision for First-Time Founders: When to Ship Software, When to Pay for It, and the Only Test That Picks
A first-time founder's guide to the build-vs-buy decision — when to pay for an existing SaaS, when to assemble a no-code stack, when to fork an open-source project, when to hire a contractor, and when the only honest answer is to build from scratch. The four-question test that picks the right path, the five situations where the answer is pre-decided, and the six-month read-out that proves which side was right.
· 14 min read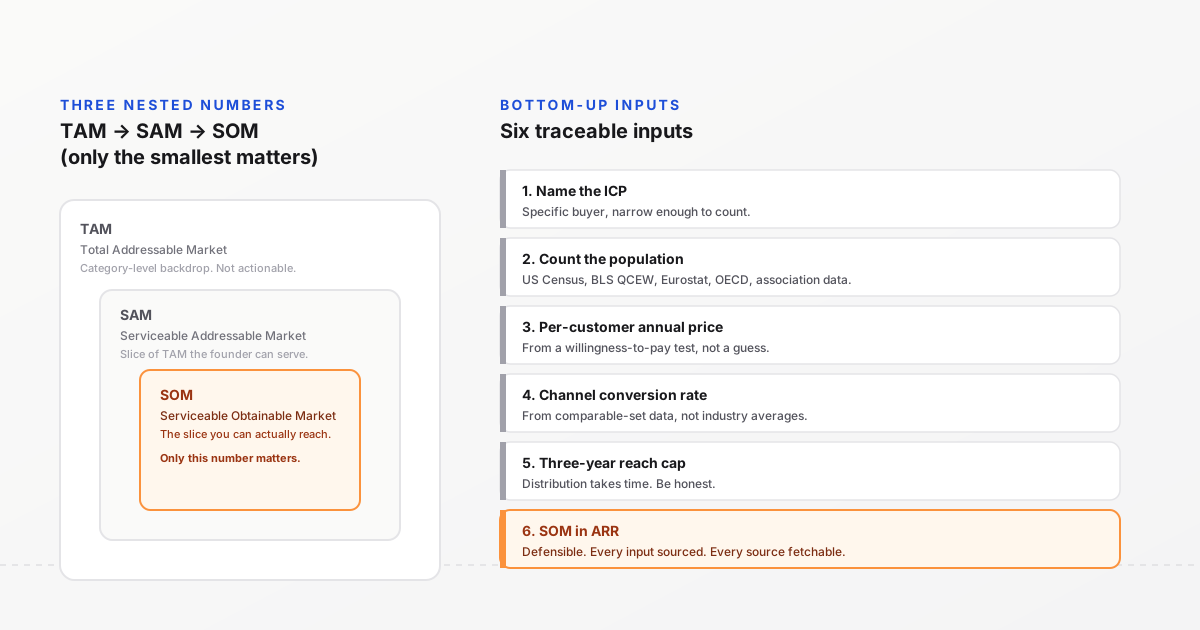
Validation Guide
How to Size a Market You Can Actually Reach: TAM, SAM, SOM, and the Two Numbers That Are Usually Useless
A founder's guide to estimating the market they can actually reach — what TAM, SAM, and SOM actually mean, why two of the three are usually useless for solo founders, how to do a defensible bottom-up sizing in a single afternoon, where to source the data, and the failure modes that produce a market-size claim a partner or investor will not trust.
· 16 min read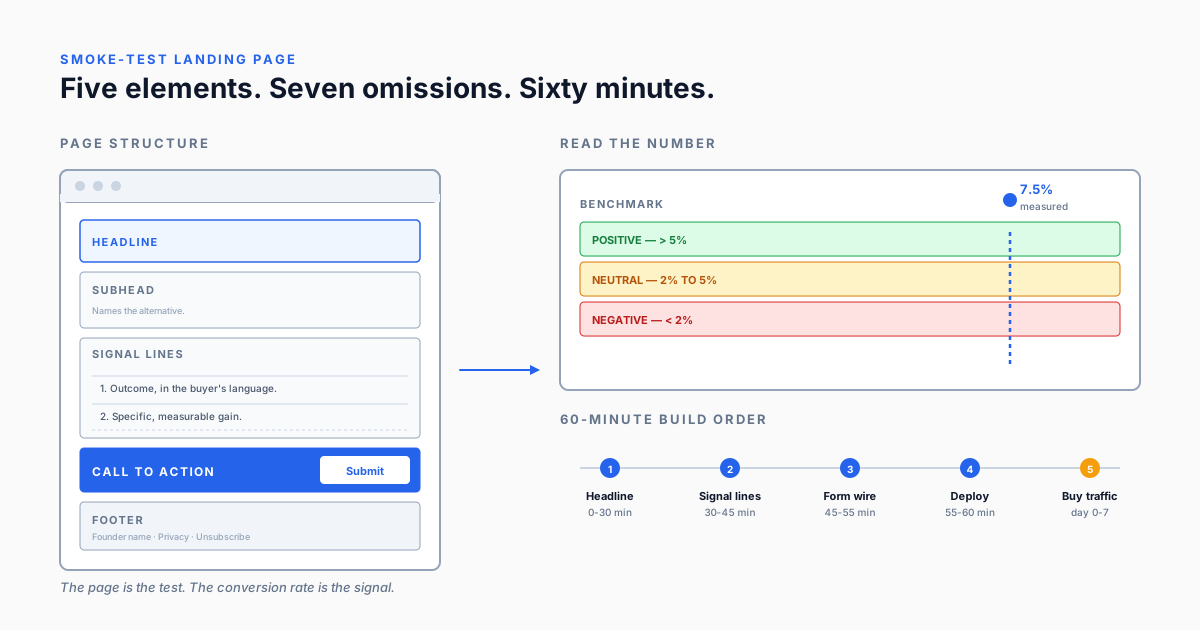
Validation Guide
How to Write a Smoke-Test Landing Page in 60 Minutes
The shortest path from a hypothesis to a real conversion number — page structure, headline formula, the four signal lines, the seven things to leave off, the 60-minute build checklist, and how to read the conversion data at small N.
· 14 min read